データ分析や品質管理、統計的仮説検定の現場で避けて通れない離散型確率分布のひとつが「超幾何分布」です。ビジネスや研究開発の現場においてサンプリング調査の精度がシビアに問われるなか、この分布の仕組みを正しく把握することは、分析の成否を分ける極めて重要なファクターとなっています。
数学や統計学の学習者がつまずきやすいのが、「二項分布と何が違うのか」「どのような場面で使い分けるべきなのか」という疑問です。今回は、非復元抽出における確率計算の基本原理から、確率質量関数、期待値・分散の導出、さらには実務や統計検定対策に直結するプログラミング実装までを余すところなく整理します。
【基礎知識】超幾何分布とは?非復元抽出が生み出す確率のメカニズム
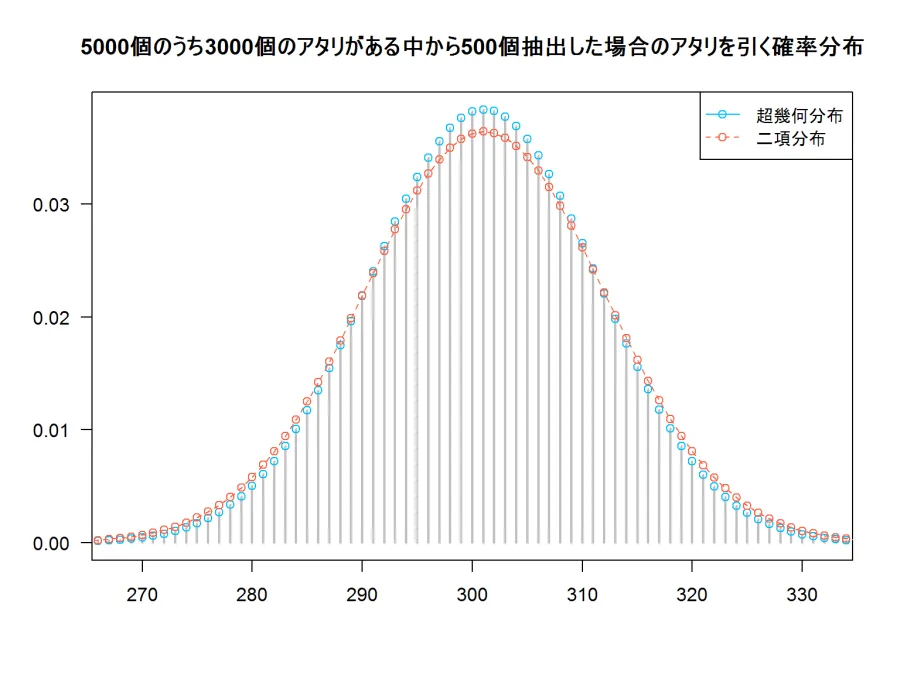
超幾何分布(Hypergeometric Distribution)は、ある有限の母集団から「元に戻さずに(非復元抽出で)」連続していくつかの要素を取り出す際に、特定の属性を持つ要素が何回含まれるかを表す離散型の確率分布です。
たとえば、総数 $N$ 個の母集団の中に、アタリ(目的の要素)が $K$ 個、ハズレが $N-K$ 個含まれている状況を想定します。ここから重複なく $n$ 個のサンプルを同時に(または1個ずつ戻さずに)抽出したとき、手元のアタリの個数 $X$ が従う確率分布こそが超幾何分布です。
このときの確率を記述する確率質量関数(Probability Mass Function: PMF)は、組み合わせ記号(コンビネーション: $_n\mathrm{C}_r$ または $\binom{n}{r}$)を用いて次のように定義されます。
$$P(X = k) = \frac{\binom{K}{k} \binom{N-K}{n-k}}{\binom{N}{n}}$$
分母の $\binom{N}{n}$ は「$N$ 個から $n$ 個を選ぶ全通りの数」、分子の $\binom{K}{k} \binom{N-K}{n-k}$ は「$K$ 個のアタリから $k$ 個を選び、かつ残り $N-K$ 個のハズレから $n-k$ 個を選ぶ場合の数」を表しています。高校数学で学ぶ「場合の数による確率の計算」が、そのまま一般化された構造です。
【比較検証】二項分布との決定的な違いと「二項近似」の境界線
超幾何分布を理解するうえで最大の焦点となるのが、超幾何分布と二項分布の違いです。両者の境界線は、標本を取り出すプロセスが「復元抽出」か「非復元抽出」かという1点に集約されます。
二項分布では、1回引くごとに結果を元に戻す「復元抽出」を前提とします。そのため、各試行でアタリが出る確率 $p$ は常に一定であり、各回の試行は完全に独立です。コイン投げやサイコロ振りが代表例にあたります。
一方、超幾何分布が対象とするのは「非復元抽出」です。1回引くごとに母集団の総数とアタリの残数が減少し、2回目以降にアタリを引く確率が直前の結果によって変化します。つまり、試行同士が独立ではありません。
ただし、母集団のサイズ $N$ がサンプリング数 $n$ に比べて圧倒的に大きい場合、1個取り出しても母集団全体の比率への影響はごくわずかです。一般に、サンプリング比率 $n/N \le 0.05$(5%以下)程度であれば、超幾何分布は二項分布(パラメータ $n, p = K/N$)によって高精度に近似できることが知られており、これを超幾何分布の二項近似と呼びます。
【くじ引きの例題で理解】公式を当てはめて確率を計算するステップ
抽象的な数式を実感するために、身近な「くじ引き」を題材にした実践的な例題を解いてみましょう。
【例題】
全部で10本のくじがあり、その中に3本のアタリが含まれています。このくじから同時に4本を引くとき、ちょうど2本当たる確率を求めよ。
パラメータを整理すると、以下のようになります。
- 母集団のサイズ:$N = 10$
- 母集団内のアタリ数:$K = 3$
- 引くくじの総数(サンプルサイズ):$n = 4$
- 手元のアタリ数:$k = 2$(したがってハズレの数は $n-k = 2$)
公式に数値を当てはめて計算を進めます。
1. 全事象の場合の数(分母):
$$\binom{10}{4} = \frac{10 \times 9 \times 8 \times 7}{4 \times 3 \times 2 \times 1} = 210$$
2. アタリ2本・ハズレ2本が出る場合の数(分子):
$$\binom{3}{2} \times \binom{7}{2} = 3 \times 21 = 63$$
3. 確率の算出:
$$P(X = 2) = \frac{63}{210} = \frac{3}{10} = 0.3 \quad (30\%)$$
このように、直感的な組み合わせの積として自然に確率が求まることが確認できます。
【数式解説】期待値・分散の導出プロセスと「有限母集団修正」の意味
超幾何分布に従う確率変数 $X$ の期待値(平均)と分散は、以下のシンプルな式で表されます。
- 期待値 $E[X]$: $n \cdot \frac{K}{N} = np$ (ただし $p = K/N$)
- 分散 $V[X]$: $n \cdot \frac{K}{N} \left(1 - \frac{K}{N}\right) \cdot \frac{N-n}{N-1} = np(1-p) \cdot \frac{N-n}{N-1}$
期待値の形は、驚くべきことに二項分布の期待値 $np$ と完全に一致します。1回ごとの抽出における成功確率の期待値が $p = K/N$ で維持されるためです。
一方、分散の式には二項分布の分散 $np(1-p)$ に対して、$\frac{N-n}{N-1}$ という補正係数が掛けられています。これは統計学で有限母集団修正(Finite Population Correction: FPC)と呼ばれる項です。
$n$ が $N$ に近づくにつれてこの係数は 0 に近づき、分散は縮小します。もし母集団のすべて($n = N$)を引き切ってしまえば、手元のアタリ数は必ず $K$ 個に固定されるため、ばらつき(分散)が 0 になるという直感とも完全に整合します。
なお、期待値や分散の導出において、確率母関数やモーメント母関数(積率母関数)を直接適用しようとすると、超幾何級数が絡み計算が極めて煩雑になります。そのため、各回の抽出を表すインジケーター変数(指示確率変数)の和として $X = I_1 + I_2 + \dots + I_n$ と分解し、共分散を考慮して導出する手法がスマートかつ一般的です。
【実務&検定対策】統計検定2級から「フィッシャーの正確確率検定」への展開
学問的な理解だけでなく、資格試験や実務の現場でも超幾何分布は中核的な役割を果たします。とりわけ統計検定2級の出題範囲では、超幾何分布の確率計算や二項分布との前提条件の違いが繰り返し問われる頻出分野です。
さらに実務応用として名高いのが、分割表(クロス集計表)の解析で用いられるフィッシャーの正確確率検定(Fisher's Exact Test)です。
医療統計やA/Bテストなどでサンプルサイズが小さい場合、カイ二乗検定のような漸近的な近似手法を用いると誤差が大きくなります。そこで「行と列の周辺合計(マージン)を固定した状態」を前提とし、得られたクロス集計表の配置パターンが生じる確率を超幾何分布に基づいて厳密に計算するのがフィッシャーの手法です。
「小標本でも妥協せず、理論通りの正確な確率を算出する」という場面において、超幾何分布の存在価値は極めて高いといえます。
【プログラミング実践】Python(scipy)とR言語(dhyper)による実装コード
現代のデータ解析環境では、手計算を行う代わりにスクリプトを用いて超幾何分布を瞬時にシミュレーション・計算します。代表的な Python と R の記述例を確認しておきましょう。
Python(scipy.stats を利用)
Python では `scipy.stats.hypergeom` を使用します。パラメータの指定順序(母集団の総数 $M$、アタリの総数 $n$、引くサンプル数 $N$)に注意が必要です。
from scipy.stats import hypergeomM: 母集団総数, n: 母集団のアタリ数, N: 抽出数
M, n, N = 10, 3, 4 k = 2 # 求めたいアタリの数確率質量関数 (PMF) の計算
prob = hypergeom.pmf(k, M, n, N) print(f"P(X = 2) = {prob:.4f}") # 出力: 0.3000期待値と分散の取得
mean, var = hypergeom.stats(M, n, N, moments='mv') print(f"期待値: {mean:.4f}, 分散: {var:.4f}")
R言語(組み込み関数 dhyper を利用)
R言語では標準関数の `dhyper` を用いて、直感的に確率質量を計算できます。
# dhyper(x, m, n, k)x: 当選数, m: 白球(アタリ)数, n: 黒球(ハズレ)数, k: 取り出す球数
prob <- dhyper(x = 2, m = 3, n = 7, k = 4) print(prob) # 出力: 0.3
このように、ツールを用いることで複雑なコンビネーション計算もわずか数行で処理可能です。
【超幾何分布】に関するよくある質問(FAQ)
Q1:超幾何分布と幾何分布はどう違うのですか?名前に共通点がありますが関係はありますか?
A1:名前は似ていますが、全く異なる分布です。幾何分布は「成功確率 $p$ の独立な試行で、初めて成功するまでの試行回数」を表す分布です。超幾何分布という名称は、その確率の母関数が数学の「超幾何級数(Hypergeometric Series)」に関連して表現できることに由来しています。
Q2:二項近似を使って良いか判断する目安はありますか?
A2:実務上は、母集団サイズ $N$ に対するサンプルサイズ $n$ の比率(サンプリングレート $n/N$)が 5%(0.05)以下、あるいは $N$ が数千以上で十分に大きい場合であれば、二項分布として近似計算を行っても実用上の誤差はほとんど問題になりません。
Q3:超幾何分布の確率変数が取り得る値の範囲(サポート)に制約はありますか?
A3:あります。手元のアタリ数 $k$ は、当然ながら母集団内のアタリ数 $K$ や引いた総数 $n$ を超えることはできません。数学的には $\max(0, n - (N - K)) \le k \le \min(n, K)$ の範囲で定義されます。
超幾何分布は、一見すると複雑な数式に見えますが、「非復元抽出」という日常的なルールを忠実に数式化した明快な構造を持っています。二項分布との決定的な違いである標本抽出の独立性を把握しておくことは、標本調査の設計や仮説検定の妥当性を評価するうえで欠かせない視点です。
小規模データの正確な検定から大規模サンプリング時の二項近似まで、前提条件に応じた適切な使い分けを意識し、日々のデータ分析や統計モデリングの実務に役立ててください。